Les plateformes décisionnelles historiques reposaient généralement sur une couche sémantique permettant aux utilisateurs de manipuler des objets métier plutôt que des tables ou des requêtes SQL.
“Clients”, “contrats”, “produits” ou “chiffre d’affaires” étaient exposés sous une forme fonctionnelle indépendante des structures physiques de stockage.
Pour répondre à ce besoin, {oa-lake} embarque nativement une couche sémantique.
Cette couche sémantique fait partie intégrante de {oa-lake}. Elle centralise les objets métier, les dimensions, les mesures, les KPIs, les règles de calcul et les mécanismes de sécurité.
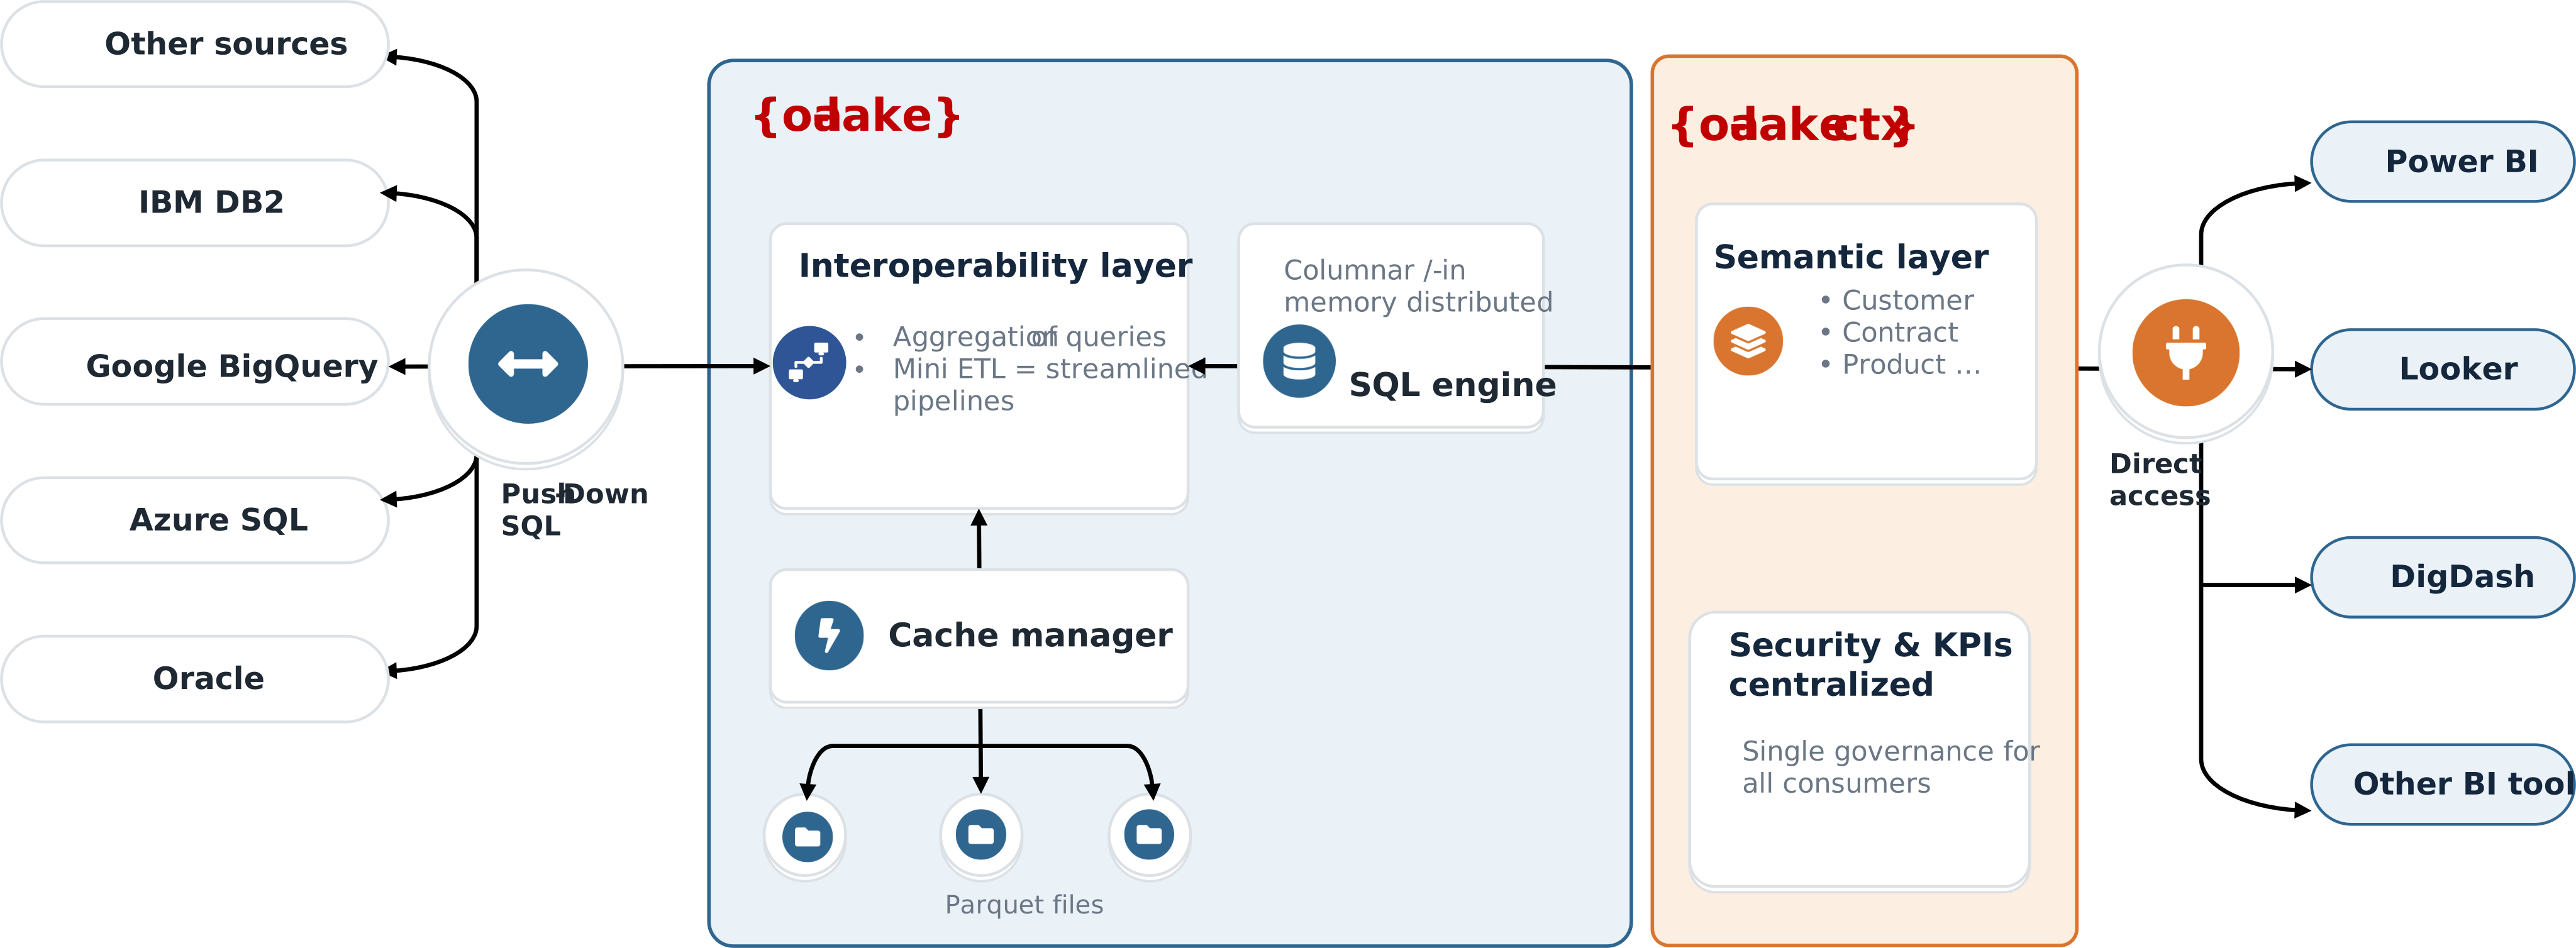
Point clé : les outils consommateurs manipulent des objets métier. Les structures physiques restent masquées.
Architecture
La couche sémantique de {oa-lake} centralise les dimensions, mesures, hiérarchies, KPI et règles de calcul.
Ces composants sont définis une seule fois puis exposés aux outils consommateurs.
Contrairement à certaines couches sémantiques du marché, celle de {oa-lake} ne nécessite ni modèle physique spécifique, ni table pivot, ni chemin de navigation imposé.
Les relations sont calculées dynamiquement à partir du modèle existant.
Point clé : un modèle métier unique pour toutes les données et tous les outils consommateurs.
Sources de données
{oa-lake} peut exploiter simultanément plusieurs systèmes de données.
Les données peuvent provenir de bases Oracle, SQL Server, PostgreSQL, DB2, Snowflake, BigQuery, Redshift, fichiers ou autres sources compatibles SQL.
Les objets métier peuvent combiner plusieurs sources dans une même définition fonctionnelle.
Usage typique : construire un KPI à partir de données réparties sur plusieurs plateformes.
Objets métier
Les catalogues exposés par {oa-lake} regroupent les dimensions, mesures, KPI, hiérarchies et nomenclatures métier.
Les relations entre objets sont définies dans la couche sémantique et non dans les outils de restitution.
Les catalogues peuvent être organisés indépendamment des structures physiques des bases de données.
Génération SQL
Les requêtes SQL sont générées dynamiquement à partir des objets métier, dimensions, mesures et filtres sélectionnés.
Les jointures, agrégations et règles de calcul sont appliquées par le moteur.
Les filtres utilisateurs sont propagés jusqu’aux systèmes sources via le mécanisme de Push-Down SQL.
Le SQL généré peut être exécuté par {oa-lake} ou par tout moteur SQL compatible.
Point clé : les utilisateurs manipulent des objets métier ; le SQL est généré automatiquement.
Interface d’exploration
{oa-lake} est livré avec une interface d’exploration des couches sémantiques.
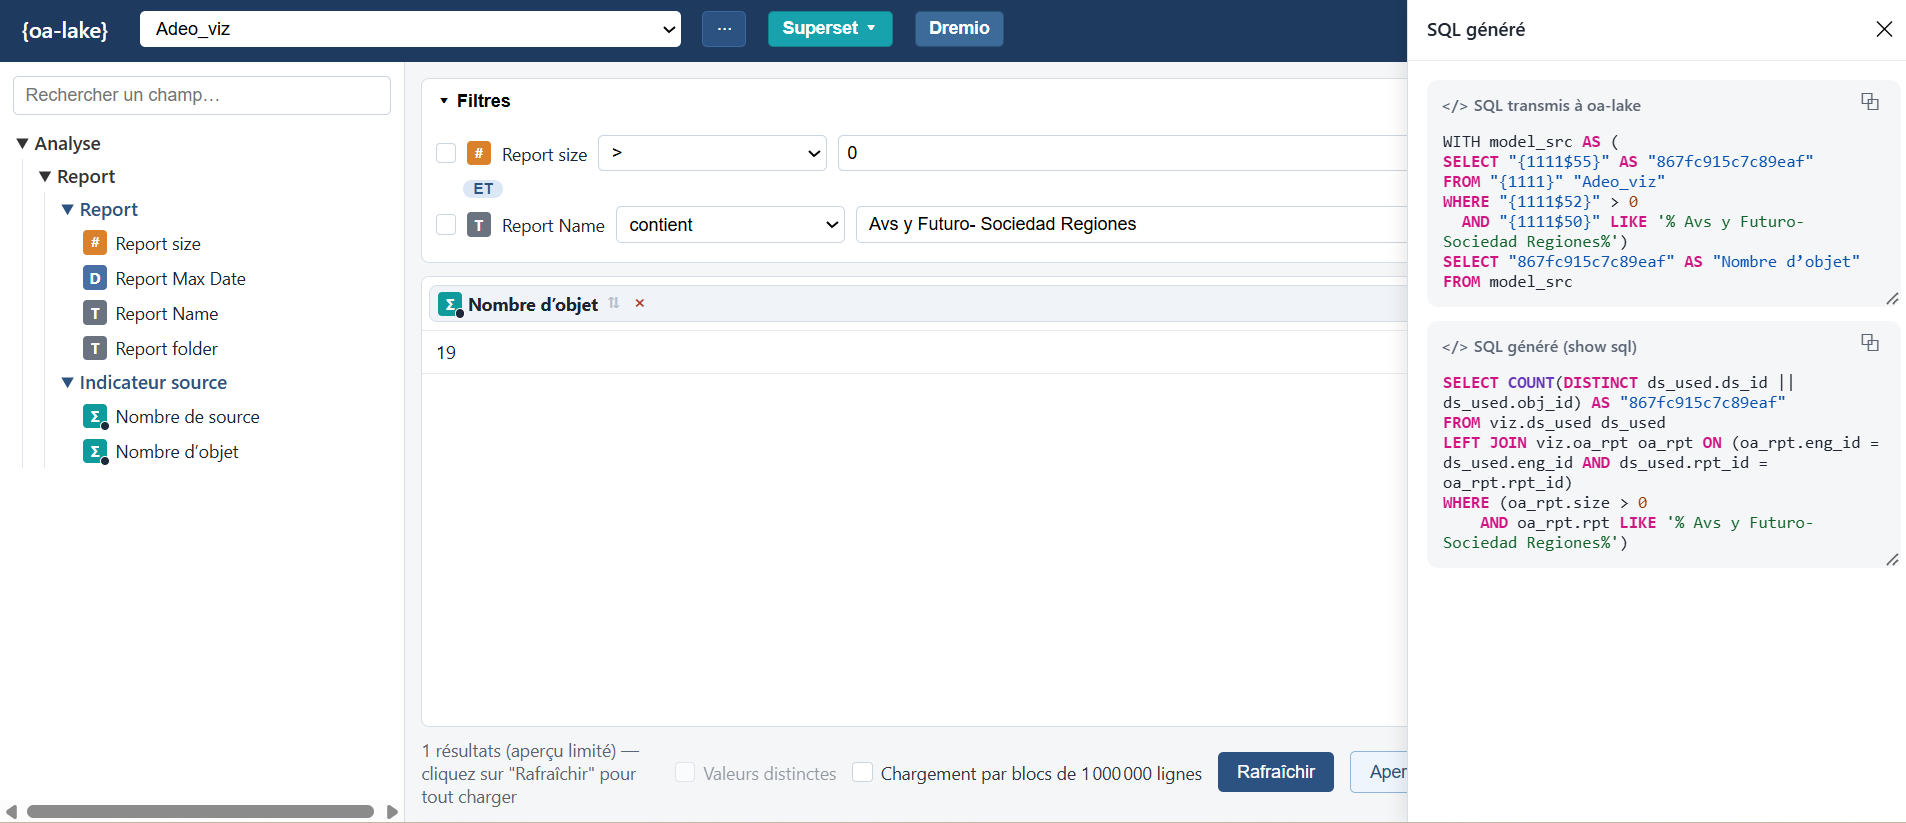
Interface d’exploration : la couche sémantique sélectionnée (en haut à gauche) expose une arborescence d’objets métier ; les objets glissés à droite servent de champs ou de filtres ; le SQL généré est affiché dans le volet latéral ; le résultat peut être basculé vers Superset, Dremio ou un autre outil de datavisualisation.
- Choix de la couche sémantique : la liste déroulante en haut à gauche donne accès aux catalogues disponibles.
- Sélection des objets métier : l’arborescence (dossiers, dimensions, mesures) est parcourue puis les objets sont basculés à droite pour être affichés ou utilisés comme filtres.
- Exécution : un aperçu limité est proposé immédiatement ; la requête complète est lancée à la demande.
- Contrôle du SQL : le SQL transmis à {oa-lake} et le SQL physique généré sont consultables et copiables.
- Restitution : le résultat peut être basculé vers un outil de datavisualisation (Superset, Dremio ou autre).
Point clé : les utilisateurs construisent leurs requêtes à partir d’objets métier, sans écrire de SQL, et gardent la visibilité sur le SQL produit.
Smart Cache
Les données restent dans les systèmes sources lorsque cela est possible.
Les jeux de données les plus sollicités peuvent être matérialisés au format Parquet.
Le cache est piloté par le Cache Manager de {oa-lake}.
La gestion du cache reste indépendante des outils consommateurs.
Point clé : les requêtes les plus coûteuses peuvent être accélérées sans modifier les systèmes sources.
SQL Engine
{oa-lake} s’appuie sur un moteur SQL columnar et in-memory.
Les requêtes générées par la couche sémantique sont exécutées par ce moteur ou propagées vers les systèmes sources selon le contexte.
Le SQL reste portable et indépendant des technologies de stockage utilisées.
Point clé : le moteur SQL constitue la couche d’exécution de l’architecture.
Sécurité
La sécurité est gérée au niveau de la couche sémantique.
Les restrictions d’accès, profils utilisateurs, catalogues métier et filtres de sécurité sont appliqués avant génération des requêtes.
Cette approche permet de reproduire les mécanismes de sécurité rencontrés dans des plateformes telles que SAP BusinessObjects ou IBM Cognos.
Point clé : les règles de sécurité sont définies une seule fois puis appliquées à tous les outils connectés.
Restitution
Les catalogues exposés par {oa-lake} peuvent être consommés par tout outil capable d’interroger une source PostgreSQL.
Power BI, Looker, Spotfire, Tableau, Qlik ou d’autres plateformes accèdent aux mêmes objets métier, dimensions, mesures et KPI.
Les définitions fonctionnelles restent identiques quel que soit l’outil utilisé.
Résultat : plusieurs plateformes peuvent partager le même catalogue métier sans duplication des règles de calcul.
Gouvernance
Les objets métier, KPI, dimensions, mesures et règles de calcul sont centralisés dans un référentiel unique.
Les évolutions fonctionnelles sont réalisées dans la couche sémantique de {oa-lake} puis immédiatement disponibles pour les outils connectés.
Point clé : la couche sémantique de {oa-lake} constitue le point central de définition des objets métier et des KPI.